التوليد المعزز بالاسترجاع RAG.. كيف يبحث الذكاء الاصطناعي في مصادرك قبل أن يجيب عن سؤالك؟
تقرير تكتبه ـ أمل علوي:
حين تسأل مساعدًا ذكيًا عن لائحة داخلية في شركتك أو عن خبر وقع هذا الأسبوع، فإن النموذج اللغوي وحده لا يملك الإجابة؛ فمعرفته تتوقف عند تاريخ تدريبه ولا تشمل مستنداتك الخاصة. وهنا تظهر تقنية التوليد المعزز بالاسترجاع، المعروفة اختصارًا باسم RAG، وهي أسلوب يجعل نموذج الذكاء الاصطناعي يبحث أولًا في مصادر خارجية موثوقة، ثم يكتب إجابته اعتمادًا على ما وجده. وقد صارت هذه التقنية من أكثر أساليب بناء تطبيقات الذكاء الاصطناعي انتشارًا في المؤسسات، لأنها تقلل الهلوسة وتتيح ذكر المصادر وتغني عن إعادة تدريب النموذج مع كل معلومة جديدة. وفي هذا التقرير نشرح معنى التوليد المعزز بالاسترجاع، وطريقة عمله، وفوائده وحدوده، وأحدث صوره.
ظهر مصطلح التوليد المعزز بالاسترجاع في ورقة بحثية نُشرت عام 2020، أعدها الباحث باتريك لويس وزملاؤه في مختبر أبحاث الذكاء الاصطناعي التابع لشركة فيسبوك، التي صار اسمها ميتا، بالتعاون مع باحثين من كلية لندن الجامعية وجامعة نيويورك. وكانت الفكرة بسيطة في جوهرها؛ فبدل أن يعتمد النموذج على ما حفظه أثناء التدريب فقط، يُزوَّد بمكوّن للبحث يسترجع نصوصًا ذات صلة بالسؤال من مكتبة خارجية، ثم يستخدمها في صياغة الإجابة. ويمكن تشبيه ذلك بالفرق بين طالب يجيب من ذاكرته في امتحان مغلق، وطالب يُسمح له بفتح الكتاب والرجوع إلى الصفحة المناسبة قبل أن يكتب.
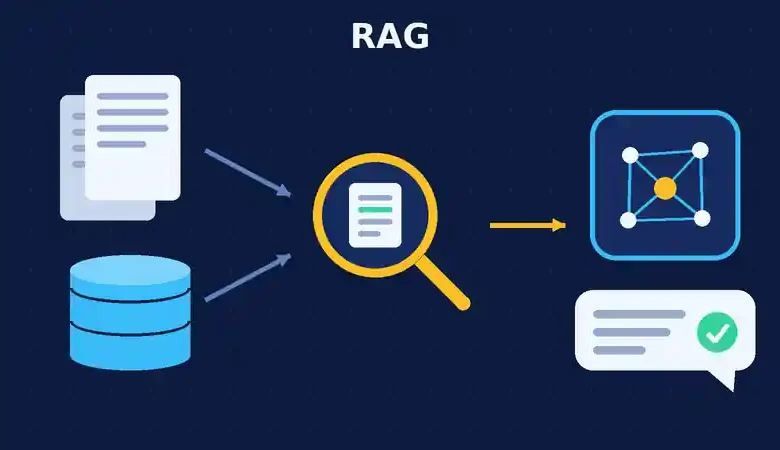
وتمر العملية بمرحلتين رئيسيتين؛ الأولى هي التجهيز، وفيها تُقسَّم المستندات إلى مقاطع صغيرة، ثم يُحوَّل كل مقطع إلى سلسلة من الأرقام تسمى «التضمينات»، وهي تمثيل رياضي لمعنى النص يجعل المقاطع المتقاربة في المعنى متقاربة في الأرقام. وتُحفظ هذه التضمينات في قاعدة بيانات متجهية، وهي نوع من قواعد البيانات صُمم للبحث بالمعنى لا بتطابق الكلمات. أما المرحلة الثانية فتبدأ عند طرح السؤال؛ إذ يُحوَّل السؤال نفسه إلى تضمين، ويبحث النظام عن أقرب المقاطع إليه في المعنى، وهو ما يسمى البحث الدلالي، ثم تُضاف المقاطع المسترجعة إلى السؤال وتُرسل معه إلى النموذج، فيكتب إجابة مبنية عليها.
وتفسر مزايا هذه الطريقة سرعة انتشارها؛ فهي تمنح النموذج معلومات حديثة دون إعادة تدريبه، إذ يكفي تحديث المستندات في قاعدة البيانات. وهي تتيح للمؤسسات استخدام بياناتها الخاصة، كالعقود ودلائل المنتجات وسجلات الدعم الفني، دون أن تصبح هذه البيانات جزءًا من النموذج نفسه. كما تسمح بعرض المصدر الذي استندت إليه كل إجابة، فيستطيع المستخدم مراجعته والتحقق منه. ولأن النموذج يكتب اعتمادًا على نص موجود أمامه، تنخفض احتمالات هلوسة الذكاء الاصطناعي، أي اختلاق معلومات غير صحيحة بثقة كاملة. ولهذا نجد التوليد المعزز بالاسترجاع خلف كثير من روبوتات خدمة العملاء، ومساعدي البحث في الوثائق القانونية والطبية، وأدوات البحث الداخلي في الشركات.
لكن التقنية ليست حلًا سحريًا؛ فجودة الإجابة مرهونة بجودة الاسترجاع، وإذا جلب النظام مقاطع غير مناسبة أو ناقصة فسيبني النموذج إجابته على أساس ضعيف. وتؤثر طريقة تقسيم المستندات في النتيجة، فالمقطع القصير جدًا يفقد سياقه، والطويل جدًا يشتت البحث. وتبقى الهلوسة ممكنة وإن قلّت، فقد يسيء النموذج تفسير نص صحيح أو يضيف إليه ما ليس فيه. ويضاف إلى ذلك جانب أمني؛ إذ يجب أن يحترم النظام صلاحيات كل مستخدم فلا يعرض عليه مستندات لا يحق له الاطلاع عليها، كما قد تحمل المستندات المسترجعة تعليمات خبيثة مدسوسة تحاول توجيه النموذج، وهو ما يعرف بحقن الأوامر.
ولمعالجة هذه النقائص تطورت التقنية في أكثر من اتجاه. فالبحث الهجين يجمع البحث بالمعنى مع البحث التقليدي بالكلمات المفتاحية، ثم تعيد نماذج متخصصة ترتيب النتائج لاختيار الأنسب. وتقنية GraphRAG، التي أتاحتها مايكروسوفت مفتوحة المصدر عام 2024، تبني خريطة للعلاقات بين الأشخاص والجهات والمفاهيم الواردة في المستندات، فتجيب عن أسئلة تحتاج إلى ربط معلومات متفرقة. أما الاسترجاع الوكيلي فيمنح وكيل الذكاء الاصطناعي حرية أن يقرر متى يبحث وأين، وأن يعيد البحث إذا لم تكفِ النتائج الأولى، وأن يراجع ما وجده قبل أن يجيب. ويرى متخصصون أن هذا الأسلوب صار النمط الأبرز في تطبيقات المؤسسات خلال عام 2026، وإن كان أعلى تكلفة وأبطأ من الصورة البسيطة.
وقد أثار اتساع النوافذ السياقية للنماذج، حتى بلغت مليون رمز في بعضها، سؤالًا عن جدوى الاسترجاع ما دام النموذج يستطيع قراءة مئات الصفحات دفعة واحدة. والواقع أن الأسلوبين يتكاملان؛ فبيانات المؤسسات تتجاوز عادة أي نافذة مهما اتسعت، وإرسال كل شيء في كل سؤال يرفع التكلفة ويبطئ الرد، كما أن دقة النماذج قد تتراجع حين يزدحم السياق بمعلومات لا علاقة لها بالسؤال. ولذلك يبقى اختيار المقاطع المناسبة بعناية خطوة أساسية حتى مع النماذج الأحدث.
وينصح الخبراء من يريد بناء نظام يعتمد على التوليد المعزز بالاسترجاع بأن يبدأ بتنظيف المستندات وتحديثها وحذف المكرر والمتعارض منها، وأن يختبر النظام على أسئلة حقيقية من واقع العمل قبل الاعتماد عليه، وأن يُلزم النموذج بذكر مصادره وبالاعتراف بعدم المعرفة حين لا يجد إجابة في المستندات، وأن يبدأ بالصورة البسيطة ثم ينتقل إلى الصور الأعقد عند الحاجة فقط. أما المستخدم العادي فيكفيه أن يتذكر أن وجود مصدر بجوار الإجابة لا يغني عن فتحه والتأكد من أنه يقول فعلًا ما نُسب إليه.
إن التوليد المعزز بالاسترجاع يجسد فكرة مهمة في الذكاء الاصطناعي المعاصر؛ وهي أن قوة النظام لا تأتي من النموذج وحده، بل من المعلومات التي توضع أمامه في اللحظة المناسبة. وبين نموذج يحفظ ونظام يبحث ثم يجيب، يتجه كثير من التطبيقات إلى الجمع بينهما، ليبقى السؤال الأهم ليس كم يعرف النموذج، بل من أين يأتي بما يقوله، وهل يمكن التحقق منه.
ــــــــــــــــــــ
هذا المحتوي تم باستخدام أدوات الذكاء الإصطناعي