«شياوبنغ» تطلق نموذج GroundingPI لإدراك الروبوتات وتقول إنه يتفوق على GPT-6 Astra
كتب – نبيل الخوارزمى
كشفت مجموعة «شياوبنغ» الصينية، بالتعاون مع فرق بحثية من جامعة بكين وجامعة هونغ كونغ وجامعات أخرى، عن نموذج GroundingPI، وهو نموذج أساسي للإدراك المتجسد يساعد الروبوتات على فهم ما تراه وتحديد مواقع الأشياء بدقة. وتقول الشركة إن نموذج GroundingPI حلّ أولًا في تقييم شامل ضم 34 اختبارًا عامًا للإدراك البصري.
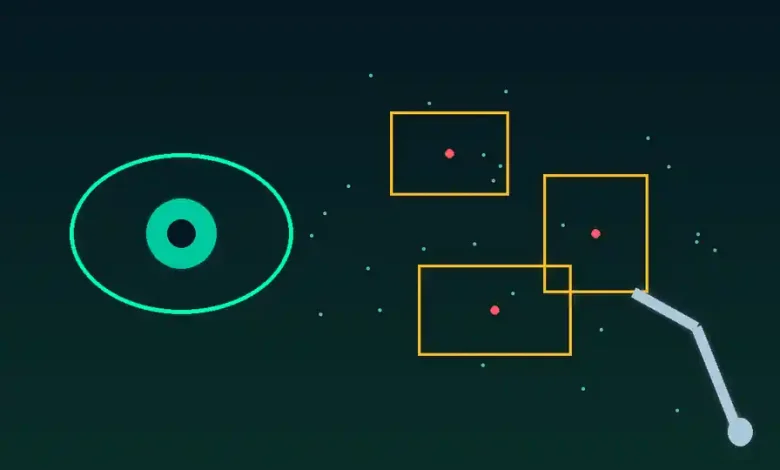
يعتمد النموذج على ما تسميه الشركة مسار «الإدراك أولًا»، بحجم يقارب 4 مليارات معامل. ويجمع اسمه بين فكرتين: «Grounding» أي الربط البصري بين الوصف اللغوي وموقع الشيء في الصورة، و«PI» اختصار للذكاء الفيزيائي. ومن أمثلة المهام التي يؤديها تحديد «مقبض الكوب الموجود على اليمين» بوضع نقطة أو مربع حوله، وهي مهارة أساسية قبل أن تمد الروبوتات أذرعها للإمساك بالأشياء.
وفي المقارنة التي أعلنتها الشركة، حصل GroundingPI على متوسط 73.68 درجة عبر 11 فئة من القدرات بأوزان متساوية، مقابل 71.54 درجة لنموذج GPT-6 Astra من «أوبن إيه آي». واللافت أن تدريبه لم يستخدم بيانات حركة الروبوتات، بل اعتمد على بيانات إدراك بصري فقط، تشمل اكتشاف الأجسام العامة والأجسام الصغيرة المتزاحمة وقراءة النصوص وتحليل تخطيط المستندات وعناصر واجهات الاستخدام وتحديد المواقع المكانية للروبوتات.
وتصف «شياوبنغ» النموذج بأنه نموذج بحثي أولي حتى الآن. ففي اختبارات المحاكاة، حقق نظام يعتمد على GroundingPI بوصفه أساسًا للرؤية نسبة نجاح مماثلة لنموذج مقارن أو أعلى منها، مع استخدام 50% فقط من بيانات العروض التوضيحية مقابل 75% للنموذج الآخر. وشملت الاختبارات مهام فرز المواد وعدّ الصناديق، مع إمكانية استخدام مجموعة الأوزان نفسها في محطات عمل مختلفة. وأتاحت الشركة صفحة المشروع والورقة البحثية والكود البرمجي والأوزان عبر منصتي GitHub وHugging Face.
ــــــــــــــــــــ
هذا المحتوي تم باستخدام أدوات الذكاء الإصطناعي