التعلم العميق.. كيف تتعلم الآلات من البيانات مثل العقل البشري؟
تقرير تكتبه ـ أمل علوي:
التعلم العميق، أو Deep Learning، هو أحد فروع تعلم الآلة الذي يعد بدوره جزءًا من مجال الذكاء الاصطناعي، ويعتمد على شبكات عصبية اصطناعية مكونة من طبقات متعددة تحاكي بصورة مبسطة طريقة عمل الخلايا العصبية في الدماغ البشري. وتقف هذه التقنية وراء معظم الإنجازات التي نشهدها اليوم، من روبوتات المحادثة وتوليد الصور إلى التعرف على الوجوه والترجمة الفورية والسيارات ذاتية القيادة.
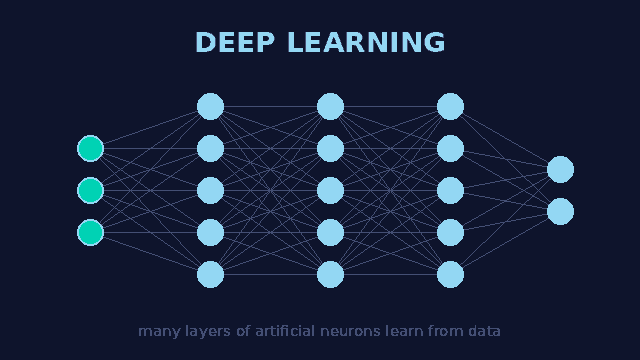
وتتكون الشبكة العصبية من وحدات صغيرة تسمى العصبونات الاصطناعية، موزعة على طبقات متتالية؛ طبقة إدخال تستقبل البيانات، وطبقات مخفية تعالجها، وطبقة إخراج تقدم النتيجة. وترتبط هذه الوحدات ببعضها عبر وصلات لكل منها قيمة رقمية تسمى الوزن، تحدد مدى تأثير كل معلومة في النتيجة النهائية. ويأتي وصف «العميق» من كثرة الطبقات المخفية، التي قد تصل إلى عشرات أو مئات الطبقات في النماذج الحديثة.
وتتعلم الشبكة عبر عملية تدريب تُعرض فيها عليها كميات هائلة من الأمثلة. فعند تعليمها التعرف على صور القطط مثلًا، تتلقى الشبكة آلاف الصور، وتقدم تخمينًا لكل صورة، ثم تقارن تخمينها بالإجابة الصحيحة، وتعدل أوزانها تدريجيًا لتقليل الخطأ. ومع تكرار هذه العملية ملايين المرات، تتعلم الطبقات الأولى اكتشاف ملامح بسيطة كالحواف والألوان، بينما تتعلم الطبقات الأعمق تمييز ملامح أكثر تعقيدًا كالأذنين والعينين، حتى تصل إلى التعرف على القطة كاملة.
وما يميز التعلم العميق عن أساليب تعلم الآلة التقليدية أنه لا يحتاج إلى أن يحدد المبرمج مسبقًا الخصائص التي ينبغي للنظام الانتباه إليها، بل يكتشفها بنفسه من البيانات الخام. وهذا ما جعله قادرًا على التعامل مع البيانات المعقدة كالصور والأصوات والنصوص بكفاءة لم تكن ممكنة من قبل.
وتتعدد أنواع الشبكات العصبية بحسب طبيعة المهمة؛ فالشبكات الالتفافية تتفوق في تحليل الصور، بينما أحدثت بنية المحولات أو Transformers ثورة في معالجة اللغة، وأصبحت الأساس الذي تقوم عليه نماذج اللغة الكبيرة الحالية. كما تُستخدم نماذج الانتشار في توليد الصور ومقاطع الفيديو انطلاقًا من وصف نصي.
وتحقق هذا التقدم بفضل اجتماع ثلاثة عوامل خلال العقد الماضي، هي توافر كميات ضخمة من البيانات الرقمية، وظهور معالجات رسومية قوية قادرة على إجراء ملايين العمليات الحسابية في وقت واحد، إلى جانب تطوير خوارزميات تدريب أكثر كفاءة. وقد نال رواد هذا المجال جوفري هينتون ويوشوا بنجيو ويان ليكون جائزة تورينج عام 2018 تقديرًا لإسهاماتهم في تطويره.
ورغم إنجازاته، يواجه التعلم العميق تحديات حقيقية، أبرزها حاجته إلى كميات هائلة من البيانات والطاقة الحاسوبية، وصعوبة تفسير الطريقة التي يصل بها النموذج إلى قراراته، وهو ما يُعرف بمشكلة الصندوق الأسود. كما قد تعكس النماذج التحيزات الموجودة في البيانات التي تدربت عليها، ما يجعل مراجعة نتائجها ضرورة، خاصة في المجالات الحساسة كالطب والتوظيف والقضاء.
ــــــــــــــــــــ
هذا المحتوي تم باستخدام أدوات الذكاء الإصطناعي