كيف تُدرَّب نماذج اللغة الكبيرة؟ رحلة من تريليونات الكلمات إلى مساعد يفهم أسئلتك
تقرير تكتبه ـ أمل علوي:
حين تسأل مساعدًا ذكيًا عن وصفة طعام أو تطلب منه كتابة رسالة أو شرح مسألة رياضية، تحصل على إجابة تبدو كأنها صادرة عن إنسان واسع الاطلاع. لكن وراء هذه الإجابة رحلة تدريب طويلة ومكلفة، تبدأ بجمع تريليونات الكلمات من النصوص، وتمر بأشهر من الحسابات على آلاف الرقائق الإلكترونية، وتنتهي بمراحل دقيقة من التهذيب والتقييم تجعل النموذج مفيدًا وآمنًا. وفي هذا التقرير نصحبك في رحلة تدريب نماذج اللغة الكبيرة خطوة بخطوة، بلغة بسيطة بعيدة عن التعقيد.
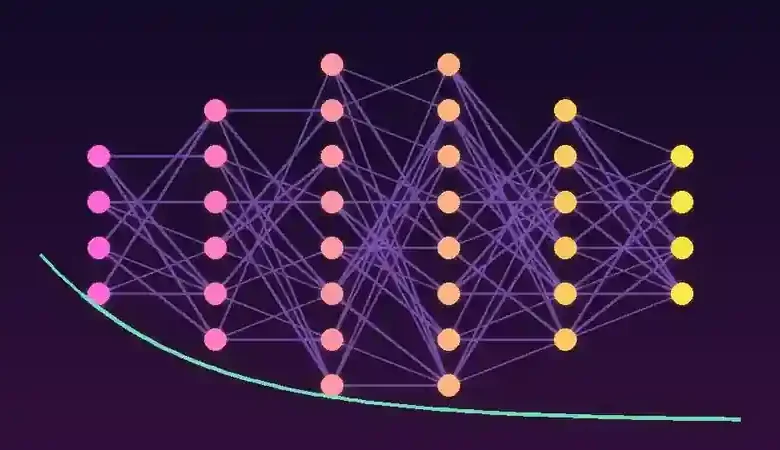
نموذج اللغة في جوهره شبكة عصبية اصطناعية ضخمة تتكون من مليارات الأرقام القابلة للتعديل، تُسمى «المعاملات» أو «الأوزان». وفي البداية تكون هذه الأرقام عشوائية تمامًا، فلا يعرف النموذج شيئًا عن اللغة أو العالم. والتدريب ليس إلا عملية طويلة لضبط هذه الأرقام تدريجيًا، حتى تصبح الشبكة قادرة على فهم النصوص وتوليدها.
تبدأ الرحلة بالبيانات؛ إذ تجمع الشركات كميات هائلة من النصوص من صفحات الويب والكتب والمقالات العلمية والأكواد البرمجية والموسوعات، وبلغات متعددة. لكن هذه البيانات الخام لا تُستخدم كما هي، بل تمر بعمليات تنظيف واسعة لحذف المحتوى المكرر والرديء والضار، وإزالة البيانات الشخصية قدر الإمكان، ثم تُقسم النصوص إلى وحدات صغيرة تُسمى التوكينز. ويُقاس حجم بيانات تدريب النماذج الحديثة بالتريليونات من هذه الوحدات، وأصبحت جودة البيانات لا تقل أهمية عن كميتها.
بعد ذلك تأتي مرحلة «التدريب المسبق»، وهي الأطول والأكثر كلفة، وتقوم على هدف بسيط إلى حد مدهش: التنبؤ بالكلمة التالية. يُعرض على النموذج جزء من جملة، فيحاول تخمين ما يليها، ثم يُقارن تخمينه بالإجابة الصحيحة الموجودة في النص، ويُحسب مقدار الخطأ. وبعدها تتولى خوارزمية تُسمى «الانتشار العكسي» تعديل مليارات المعاملات تعديلًا طفيفًا في الاتجاه الذي يقلل هذا الخطأ. وتتكرر هذه العملية مليارات المرات، ومن هذا الهدف البسيط تنشأ قدرات مدهشة؛ فلكي يتنبأ النموذج بالكلمة التالية بدقة عليه أن يتعلم قواعد اللغة، والحقائق عن العالم، وأساليب الاستدلال، وحتى أسلوب كتابة الأكواد.
وتحتاج هذه المرحلة إلى قوة حوسبة هائلة، إذ تعمل آلاف أو عشرات الآلاف من وحدات معالجة الرسوميات، أو الرقائق المتخصصة مثل وحدات TPU من جوجل، بشكل متزامن لأسابيع أو أشهر. وتصل تكلفة تدريب النماذج الرائدة إلى مئات الملايين من الدولارات، مع استهلاك ضخم للكهرباء، ولهذا تتسابق الشركات الكبرى على بناء مراكز بيانات عملاقة. وقد لاحظ الباحثون ما يُعرف بـ«قوانين التوسع»، أي أن أداء النماذج يتحسن بطريقة يمكن توقعها كلما زاد حجم البيانات وقوة الحوسبة وعدد المعاملات، وهو ما غذّى سباق الحجم خلال السنوات الماضية.
وفي نهاية التدريب المسبق نحصل على ما يُسمى «النموذج الأساسي»، وهو نموذج واسع المعرفة يجيد إكمال النصوص، لكنه لا يعرف بعد كيف يتصرف كمساعد؛ فإذا سألته سؤالًا قد يكمل كتابة أسئلة أخرى بدلًا من الإجابة. ولهذا يحتاج إلى مرحلة «الضبط الدقيق»، التي يُدرَّب فيها على عشرات أو مئات الآلاف من الأمثلة المختارة بعناية لأسئلة وطلبات مع إجابات نموذجية، فيتعلم اتباع التعليمات والإجابة بوضوح وتنظيم.
ثم تأتي مرحلة التهذيب بالتعلم المعزز، وأشهر أساليبها «التعلم المعزز من ملاحظات البشر»؛ إذ يُطلب من مقيّمين بشريين المقارنة بين إجابتين للسؤال نفسه واختيار الأفضل، وتُستخدم هذه الاختيارات لتدريب «نموذج مكافأة» يتعلم ذوق البشر وتفضيلاتهم، ثم يُحسَّن النموذج الأصلي ليحصل على مكافآت أعلى. وقد طورت الشركات أساليب أخرى إلى جانب ذلك، مثل منهج «الذكاء الاصطناعي الدستوري» الذي تعتمده Anthropic ويقوم على مجموعة مبادئ مكتوبة يُقيَّم النموذج على أساسها، والتعلم المعزز بمكافآت قابلة للتحقق في مسائل الرياضيات والبرمجة، حيث يُكافأ النموذج عندما يصل إلى الحل الصحيح، وهو ما ساعد على ظهور «نماذج التفكير» التي تفكر خطوة بخطوة قبل أن تجيب.
ولا يُطلق النموذج مباشرة بعد التدريب، بل يخضع لسلسلة من الاختبارات المعيارية لقياس قدراته في مجالات مثل الرياضيات والبرمجة والفهم القرائي، ولاختبارات أمان يحاول فيها خبراء ما يُعرف بـ«الفريق الأحمر» دفعه إلى سلوكيات ضارة لاكتشاف الثغرات وإصلاحها قبل وصوله إلى الجمهور. وبعد الإطلاق تستمر الشركات في تحسين النماذج وتحديثها بناءً على الاستخدام الفعلي.
ويواجه تدريب نماذج اللغة اليوم تحديات كبيرة، أبرزها اقتراب النصوص البشرية عالية الجودة المتاحة على الإنترنت من النفاد، ما دفع الشركات إلى الاعتماد المتزايد على «البيانات الاصطناعية» التي تنتجها نماذج أخرى. كما تتصاعد القضايا القانونية المتعلقة بحقوق النشر واستخدام أعمال الكتّاب والصحفيين والفنانين في التدريب، إلى جانب المخاوف من استهلاك الطاقة، ومن انتقال التحيزات الموجودة في البيانات إلى سلوك النماذج.
إن الإجابة التي تظهر أمامك في ثوانٍ هي حصيلة تريليونات الكلمات وأشهر من الحسابات وجهود آلاف الباحثين والمقيّمين. وفهم هذه الرحلة يساعدنا على إدراك نقاط قوة هذه النماذج وحدودها معًا؛ فهي تعلمت من النصوص البشرية كل ما فيها من معرفة وإبداع، لكنها ورثت أيضًا ما فيها من أخطاء وتحيزات، وهو ما يجعل التفكير النقدي عند استخدامها ضرورة لا رفاهية.
ــــــــــــــــــــ
هذا المحتوي تم باستخدام أدوات الذكاء الإصطناعي